Qwen или Claude: во сколько обходится каждый вариант и какие результаты они дают
Обновлено: 21 ноября 2026 года
Qwen или Claude? В написании кода Claude далеко впереди. По результатам независимого теста по программированию Terminal-Bench 4.1 лучшие модели Claude решают около 66 задач из 100. Модель Qwen3.8-Max, единственная от Qwen в этом тесте, справляется примерно с 27 задачами, оставаясь на уровне Claude конца мая. Стоимость запуска у них сопоставима или ниже у Qwen, но меньшая цена не покрывает нерешённые задачи.
Главное преимущество Qwen заключается в возможности запускать модель на собственных серверах, поэтому код и данные остаются внутри компании. Модель с открытыми весами Qwen3.8-27B распространяется бесплатно по лицензии Apache-2.0, но независимых оценок её работы нет. По собственным тестам Alibaba она достигает 75–91 % результата Qwen3.8-Max. Однако аренда видеокарт (GPU) для запуска модели на всю команду обойдётся дороже тарифа Claude для одного человека и для команды из 10 человек. При масштабе примерно в 200 человек это также обычно дороже (стоимость в расчёте на разработчика).
Коротко о главном:
- Разработка кода. В тестах на написание кода лучшие модели Claude решают около 66 задач из 100, а Qwen3.8-Max показывает результат 27. Оба показателя получены в инструменте Claude Code от компании Anthropic при максимальном уровне рассуждений (настройка max).
- Чат-боты и ИИ-агенты. Выбирайте по тому, куда можно передавать данные. На компактных моделях расходы на токены для чат-бота остаются невысокими при любом объёме работы.
- Собственные серверы. Это даёт контроль над кодом и данными. При почасовой аренде видеокарт по прайсу это стоит дороже тарифа Claude для одного человека и команды из 10 человек, а при масштабе около 200 человек — как правило, тоже дороже тарифа Claude. Расчёты по видеокартам учитывают, что задача каждого пользователя помещается в память, но они ничего не говорят о скорости: её можно узнать только в ходе нагрузочного тестирования на ваших задачах.
- В России за рубли. Российские облачные провайдеры продают модели Qwen с оплатой за токены. Расчёт только расходов на токены для чат-бота при 100 000 диалогов объёмом около 4 000 токенов в месяц по прайс-листам на 21 ноября 2026 года даёт от 9 200 до 89 900 рублей в месяц в зависимости от провайдера и модели. Selectel не указывает условия по НДС, а MWS и Cloud.ru включают НДС. В эту сумму не входят настройка и наши услуги (как оплачивать в рублях). В общем тесте на знание русского языка модели Qwen от этих провайдеров, у которых есть результат в этом тесте, уступают Claude (Qwen на русском языке). Токены на рассуждения здесь не учитываются, поэтому сумма показывает минимальный порог затрат.
Используемые названия моделей:
- Qwen (в русской транскрипции «Квен»): семейство ИИ-моделей от Alibaba; Claude: семейство от Anthropic.
- Qwen3.8-Max: флагманская облачная модель от Alibaba, единственная модель Qwen с результатами тестов.
- Qwen3.8-27B: модель Qwen для запуска на одной видеокарте, без результатов тестов.
- Qwen4-Max: новейшая облачная модель от Alibaba, пока без результатов тестов.
- Claude Opus 5.5, Sonnet 5.5 и Haiku 5.5: большая, средняя и малая модели от Anthropic.
Для компаний в России. В правилах поддерживаемых регионов компании Anthropic (по состоянию на 19 ноября 2026 года) Россия не указана. С 12 ноября 2026 года ограничения распространяются также на юридические лица, зарегистрированные или имеющие головной офис в неподдерживаемом регионе, а также на компании, где такой структуре принадлежит мажоритарная доля или контроль. Местонахождение сотрудников значения не имеет. Это касается в том числе моделей Claude, доступных через облачные платформы и официальных реселлеров. Затрагивают ли эти правила вашу компанию, лучше проверить вместе с юристом.
Если эти правила распространяются на вашу компанию, ключевой вопрос статьи меняется: где запускать Qwen. Варианта два: на собственных серверах или через российский облачный сервис с оплатой в рублях. Ниже мы привели расчёты в рублях для обоих путей. Мы не проверяли, работают ли облако Alibaba и зарубежные GPU-провайдеры с российскими компаниями в качестве клиентов, так как рублёвые варианты от этого не зависят. В этой статье мы сравниваем только Qwen и Claude, не затрагивая отечественные модели. Расчёты в долларах и показатели Claude мы сохранили для сравнения и для компаний, на которые эти ограничения не распространяются.
Содержание
- Выбор решения: Qwen или Claude в зависимости от того, должны ли код и данные оставаться в контуре компании
- Ваши собственные GPU или Claude: стоимость в пересчёте на разработчика
- Отставание Qwen в написании кода
- Сколько стоит вайбкодинг для команд разных размеров
- В рублях: Qwen3.8-27B на GPU в российском дата-центре и Qwen3.8-Max через Cloud.ru
- Насколько хорош Qwen на русском?
- Чат-боты и ИИ-агенты: сколько стоят Qwen или Claude либо работа на собственных серверах
- Qwen API в рублях в российском облаке
- Что даёт запуск модели своими силами и во сколько это обходится помимо GPU
- Как выбрать между Qwen и Claude: тест на ваших задачах
- Часто задаваемые вопросы
- Что изменилось с первой публикации этой страницы
Выбор решения: Qwen или Claude в зависимости от того, должны ли код и данные оставаться в контуре компании
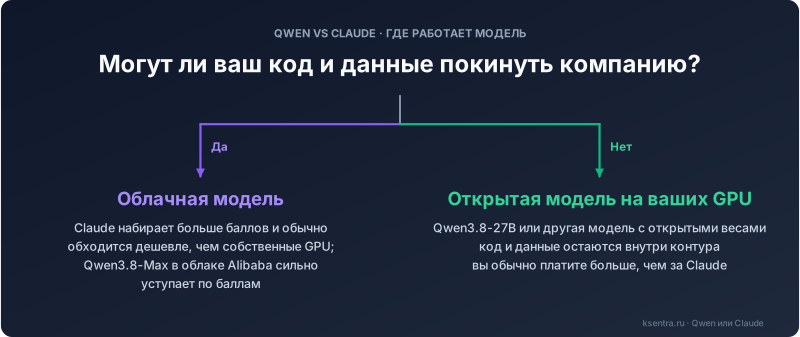
Если ваш код и данные можно передавать в облако, Claude набирает существенно больше баллов, чем Qwen3.8-Max, и обычно обходится дешевле собственных GPU. Если передавать данные за пределы компании нельзя, вы запускаете модель с открытыми весами вроде Qwen3.8-27B на своих серверах. В этом случае вы платите больше, чем за Claude, для одного человека и для команды из 10 сотрудников, а при масштабе около 200 человек — обычно тоже больше.
| Вариант | Решено задач из 100 (Terminal-Bench 4.1) | Кто запускает модель | Расходы на разработку в месяц: 1 человек | Команда из 10 человек | Около 200 человек | В чём компромисс |
|---|---|---|---|---|---|---|
| Claude Opus 5.5, оплата по факту | 65,76 | Anthropic | $150–250 | $1 238–2 062 | $22 125–36 875 | максимальный результат в этом сравнении; счёт растёт вместе с объёмом работы |
| Claude Sonnet 5.5, оплата по факту | 63,94 | Anthropic | $175–389 | $1 444–3 205 | $25 816–57 310 | результат близкий к максимальному; тратит больше токенов на задачу, чем Opus, поэтому в этом тесте обходится дороже |
| Qwen3.8-Max в облаке Alibaba | 26,97 | Alibaba | $53–246 | $437–2 026 | $7 821–36 227 | самый низкий результат в тесте; стоит дешевле Sonnet, а по верхнему порогу сравнима с Opus |
| Qwen3.8-27B на собственных GPU | нет оценки | вы, на арендованных или собственных GPU | $2 081–2 873 аренда в GPU-облаке (одна H100) | $4 162–5 746 (две H100) | $33 682–74 599 (6–11 B200) | код и данные не покидают периметр компании; расходы на специалистов, настройку и обслуживание оплачиваются отдельно |
Наши расчёты опираются на официальные цены поставщиков и почасовую аренду видеокарт (H100: прайс одного из американских облачных провайдеров на 23 октября; B200: прайсы двух других провайдеров). Оценки: каждая модель в Claude Code работает на максимальном уровне рассуждений (настройка max) из таблицы лидеров. Строки Claude рассчитаны по модели оплаты за фактическое использование на основе средних данных от Anthropic; сравнение тарифов Claude приведено в разделе стоимость в расчёте на разработчика. Собственные видеокарты подобраны так, чтобы незавершённая задача каждого разработчика (от 128 до 256 тысяч токенов) целиком помещалась в память видеокарты из расчёта одна сессия на FTE (эквивалент полной занятости) разработчика (это требования к памяти, а не к скорости). Размеры команд — примеры, подставьте свои; методика подсчёта каждой ячейки описана в разделе таблица расходов на кодинг. Модель Qwen4-Max (от 16 ноября) пока не имеет баллов в этом тесте; по данным Alibaba, она стоит $1,5 за миллион входных токенов и $4,5 за миллион выходных токенов.
В примере с командой из 200 человек агенты расходуют на токены около $60–2 600 в месяц (чат-боты и агенты). В основе этого расчёта лежит 21 000 задач в месяц объёмом по 50 000 токенов каждая. Диапазон зависит от модели и от объёма закэшированного текста, то есть информации, которая уже прочитана системой и тарифицируется по сниженной ставке.
Ваши собственные GPU или Claude: стоимость в пересчёте на разработчика
Расчёт затрат в месяц на один FTE разработчика (мы считаем тестировщика как половину разработчика, а аналитика или менеджера — как четверть):
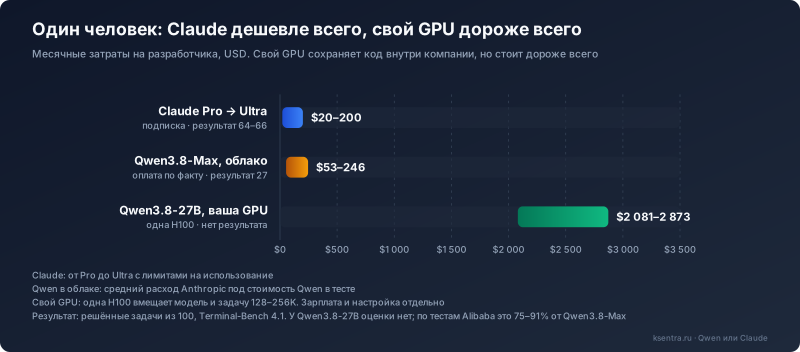
- один разработчик: $2 081–2 873 за одну видеокарту H100 против $20–200 за подписку Claude;
- команда из 10 человек (8,25 FTE разработчиков): $504–696 на один FTE, в сумме $4 162–5 746 за две видеокарты H100, против $30–152 на тарифном плане Claude Team ($250–1 250 на всю команду);
- около 200 человек (147,5 FTE разработчиков): $228–506 на один FTE, в сумме $33 682–74 599 за 6–11 видеокарт B200, против $177–277 на тарифном плане Claude Enterprise ($20 за подписку плюс оплата использования по средним расценкам Anthropic в нашей оценке).
Расходы на GPU рассчитаны по почасовым прайсам для модели Qwen3.8-27B с учётом того, что задача каждого пользователя размером 128–256 тысяч токенов полностью помещается в память. Эти цифры не отражают скорость работы, а затраты на персонал и настройку инфраструктуры идут отдельно. Тарифные планы Pro, Ultra и Team имеют ограничения на использование, а на плане Enterprise оплата за использование начисляется сверх стоимости подписок.
Обеспечение конфиденциальности кода и данных внутри компании требует дополнительных инвестиций. Если вы готовы передавать данные в облако, Claude обычно обходится дешевле собственных серверов и показывает лучшие результаты среди всех сравниваемых моделей.
Ниже приведён расчёт в рублях по прайс-листам от 21 ноября 2026 года в расчёте на один FTE разработчика в месяц. Сравниваем работу Qwen3.8-27B на GPU, арендованных в российском дата-центре, с тарифами Claude. Цены Claude пересчитаны из долларов по курсу ЦБ 82,19 ₽ (компания не продаёт подписки в рублях):
- один разработчик: Qwen3.8-27B на одном GPU H100 стоит 246 100–614 900 ₽ против подписки Claude за $20–200 (около 1 600–16 400 ₽);
- команда из 10 человек: Qwen3.8-27B на двух GPU H100 стоит 61 100–149 100 ₽ против Claude Team (около 2 500–12 500 ₽);
- около 200 человек: Qwen3.8-27B на 8–15 GPU H200 стоит 16 500–42 300 ₽ (в прайсах изученных российских облаков нет B200, а Selectel предлагает B300 только серверами из 8 GPU от 9 000 000 ₽ в месяц) против Claude Enterprise (около 14 600–22 800 ₽ в пересчёте).
Стоимость аренды GPU: нижняя граница основана на почасовом прайсе одного из облачных провайдеров без указания НДС, верхняя включает управляемый сервис с НДС 22 % или выделенный сервер. Подробный разбор смотрите в разделе расчётов в рублях. В рублях собственные GPU также обходятся значительно дороже Claude для одного человека и для команды из 10 сотрудников. При штате около 200 человек нижняя планка аренды (16 500 ₽) близка к стоимости Claude Enterprise (14 600–22 800 ₽ без учёта налогов), при этом самый дешёвый GPU-провайдер не указывает, входит ли НДС в цену. Если компания не может использовать Claude, облачной альтернативой с оплатой в рублях выступает Qwen3.8-Max через Cloud.ru. Это обходится примерно в 9 400–15 700 ₽ на один FTE разработчика в месяц для команды любого размера с учётом НДС (на основе прайса Cloud.ru). Результат модели находится на уровне 27 задач из 100. Стоимость указана по нижней границе.
Отставание Qwen в написании кода
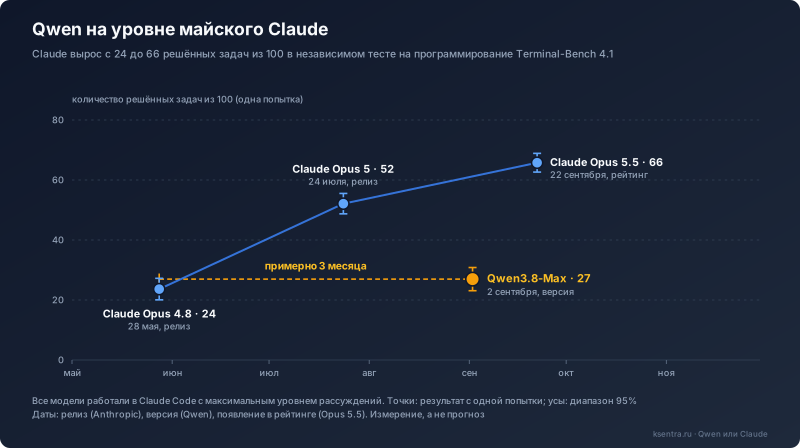
В задачах программирования Claude заметно опережает Qwen. Единственная протестированная модель от Qwen — Qwen3.8-Max (версия от 2 сентября) — набирает примерно столько же баллов, сколько модель Claude от 28 мая (23,64). Независимый тест Terminal-Bench 4.1 показывает, что лучшие модели Claude успешно справляются примерно с 66 задачами из 100, тогда как Qwen3.8-Max решает около 27.
Terminal-Bench 4.1 даёт ИИ-агенту реальные задачи в терминале (текстовом окне, где разработчики вводят команды) и проверяет результат. Каждая модель получает 330 попыток, поэтому показатель «27 из 100» означает долю успешных одиночных попыток. Все приведённые ниже результаты получены в Claude Code (инструменте разработки от Anthropic) на максимальном уровне рассуждений (настройка max). Эта настройка определяет время на размышление модели перед действием, хотя одинаково ли она работает у разных поставщиков, не уточняется.
| Модель в Claude Code на настройке max | Решено задач из 100 (диапазон в тесте) | Дата |
|---|---|---|
| Claude Opus 5.5 | 65,76 (62,7–68,9) | Сентябрь 2026 года (в рейтинге с 22 сентября) |
| Qwen3.8-Max в облаке Alibaba | 26,97 (23,1–30,8) | Версия от 2 сентября 2026 года |
| Claude Opus 4.8 | 23,64 (20,1–27,2) | Опубликована 28 мая 2026 года |
Claude Fable 5 в рейтинге с 9 июня 2026 года: 44,85 (41,0–48,7).
Диапазон результатов Qwen3.8-Max пересекается с Opus 4.8, поэтому тест не позволяет надёжно отделить их друг от друга. Следующая по дате модель Fable 5 показывает результат выше. За 117 дней с 28 мая по 22 сентября лучший показатель Claude вырос с 23,64 до 65,76. В день выхода версии Qwen3.8-Max лучшим результатом Claude на настройке max были 57,27 балла у модели Fable 5.1.
Что этот тест не показывает
- У Qwen в нём всего один результат. Это модель Qwen3.8-Max в облаке Alibaba. Для Qwen4-Max (16 ноября) и моделей Qwen для собственных серверов данных в тесте нет.
- Инструмент тестирования. Компания Alibaba тестирует Qwen3.8-Max в Claude Code, а на странице модели указывает, что модель показывает лучший результат именно в Claude Code. При этом Kimi K3.1 Pro в том же инструменте набирает намного больше баллов (пункт 3), поэтому инструмент не объясняет разрыв. Одно ограничение: результатов Qwen в её собственном инструменте Qwen Code в тесте нет.
- Другие модели в этом же инструменте ближе к Claude. Kimi K3.1 Pro набирает 59,70 при затратах на тест $1 087 по данным самого рейтинга. Это лучший результат среди моделей с открытыми весами в этом рейтинге: Moonshot AI публикует веса (около 2,8 триллиона параметров, около 1,6 ТБ: больше, чем вмещает один сервер с 8 GPU H200 или B200) по своей лицензии, которая требует отдельного договора только от группы компаний, продающей доступ к ИИ-моделям и имеющей выручку более $20 млн в год, тогда как для внутреннего использования договор не нужен. GLM-5.3 набирает 41,21, что близко к 40,00 у Claude Haiku 5.5. Сравнение открытых моделей с Claude.
Qwen Code vs Claude Code: сравнение собственного инструмента Qwen с Claude Code и другими решениями приводится в нашем обзоре инструментов разработки, а разбор инструмента от OpenAI — в сравнении с Codex.
Сколько стоит вайбкодинг для команд разных размеров
Стоимость использования Claude для кодинга зависит от выбранного формата оплаты: по тарифному плану за каждую подписку или по факту использования за токены (оба варианта приведены ниже). В пересчёте на один тестовый прогон Qwen3.8-Max стоит дешевле Sonnet, а по сравнению с Opus обходится в сумму от трети до примерно такого же уровня. Если сопоставлять расходы с затратами на тарифы Claude для команд каждого размера, то для одного человека и для группы из 10 специалистов Qwen оказывается дороже. При размере команды около 200 человек стоимость становится ниже или примерно равной (см. графики ниже), однако при этом модель набирает существенно меньше баллов при любом размере команды. Использование модели Qwen3.8-27B на собственных серверах с удержанием длинных задач в памяти обойдётся дороже в расчёте на один FTE разработчика, чем тарифы Claude для одного специалиста и команды из 10 человек. При размере команды около 200 человек это решение обычно требует больших затрат ($228–506 против $177–277) ещё до учёта расходов на зарплату инженеров и настройку, при этом у модели нет результата в этом тесте.
| Вариант | Решено задач из 100 | Кто запускает модель | Один человек | Команда из 10 человек (около 8 FTE разработчиков) | Около 200 человек (около 148 FTE разработчиков) |
|---|---|---|---|---|---|
| Claude Opus 5.5, оплата по факту | 65,76 | Anthropic | $150–250 | $1 238–2 062 | $22 125–36 875 |
| Claude Sonnet 5.5, оплата по факту | 63,94 | Anthropic | $175–389 | $1 444–3 205 | $25 816–57 310 |
| Qwen3.8-Max в облаке Alibaba, оплата по факту | 26,97 | Alibaba | $53–246 | $437–2 026 | $7 821–36 227 |
| Подписки Claude (действуют лимиты использования) | зависит от модели | Anthropic | $20–200 (от Pro до Ultra) | $250–1 250 (Team: от базовых до премиум-подписок) | $26 125–40 875 (Enterprise по $20 за подписку плюс фактическое потребление по среднему уровню Anthropic, наше предположение) |
| Qwen3.8-27B на собственных видеокартах, аренда облака, каждая задача хранится в памяти | нет оценки | вы | $2 081–2 873 (одна H100) | $4 162–5 746 (две H100) | $33 682–74 599 (6–11 B200) |
Все данные в таблице: итоговые затраты за месяц на основе базовых цен поставщиков. Размеры команд приведены для примера. Затраты на один FTE разработчика получаются делением суммы в ячейке на 1; 8,25 или 147,5. Чтобы рассчитать показатель для вашей компании, умножьте полученную цифру на количество разработчиков + 0,5 × тестировщиков + 0,25 × остальных сотрудников. Расчёт для собственных видеокарт предполагает постоянное удержание задач объёмом 128–256 тысяч токенов в памяти GPU. Исходные параметры описаны в блоке «Как мы считали».
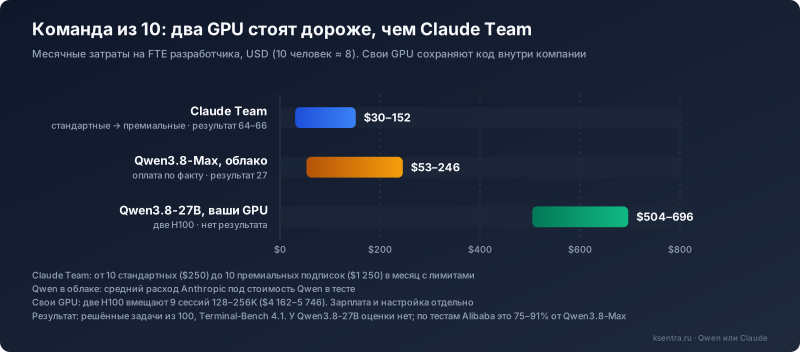
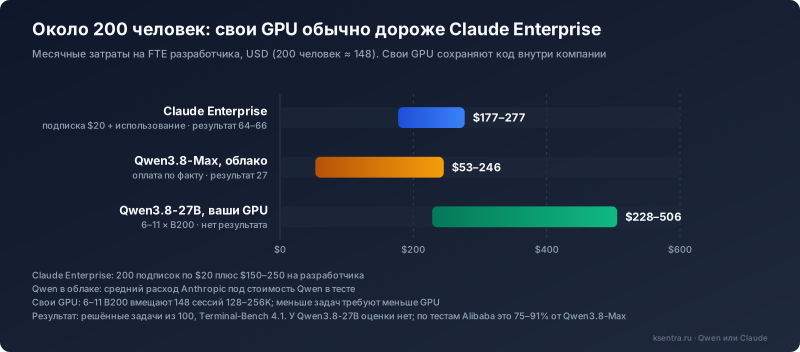
По данным Anthropic, в корпоративных внедрениях использование Claude Code обходится в среднем в $150–250 на разработчика в месяц. Точное соотношение моделей компания не раскрывает (подробнее про тарифы в статье Тарифы Claude Code для бизнеса). Мы приняли эти средние значения за ориентир для Opus 5.5. Затраты для других моделей рассчитаны пропорционально стоимости полного прогона того же теста: Opus 5.5 обходится в $4 299–4 719, Sonnet 5.5 стоит $5 016–7 334, а Qwen3.8-Max выходит в $1 519–4 636.
На практике команда комбинирует модели Claude: например, Opus отвечает за планирование и ТЗ, а Sonnet берёт на себя основной код. В итоге счёт оказывается между значениями этих двух строк. Разные модели расходуют различное количество токенов на одинаковые задачи. Sonnet потребовал в 2,4 раза больше токенов, чем Opus. Основную часть этого объёма составило повторное чтение ранее сохранённого контекста из кэша, который тарифицируется по сниженной ставке. По этой причине цена за отдельный токен мало о чём говорит. Реальный бюджет можно определить на пилотном проекте.
Как мы считали расходы на разработку
- Размер: команда из 10 человек состоит из 7 разработчиков, 2 тестировщиков, 1 аналитика или руководителя проекта; команда около 200 человек включает 120 разработчиков, 30 тестировщиков, 50 аналитиков, руководителей проектов и IT-специалистов. Веса по нашей оценке распределяются так: разработчик равен 1, тестировщик равен 0,5, остальные равны 0,25. Эти же веса определяют сессии на собственных видеокартах (1, 9 и 148).
- Стоимость тестового запуска двумя способами: токены каждой модели на тесте оцениваются по базовой цене в Anthropic или Alibaba до налогов, без учёта платы за запись текста в кэш, которую тест не отражает. Кэш — текст, который поставщик уже обработал и сохраняет, при повторном использовании он тарифицируется дешевле. Второй способ опирается на итоговый счёт по версии самого теста. Каждый диапазон идёт от меньшего из двух значений к большему.
- Подписки: источник: страница цен Claude, цены до налогов, помесячная оплата. Тариф Claude Team стоит от $25 за стандартную подписку до $125 за премиальную, Claude Code входит в оба варианта. Цены Claude Enterprise составляют $20 за подписку при годовой оплате плюс расходы на использование, которые мы берём по средним данным Anthropic исходя из нашего допущения.
- GPU для Qwen3.8-27B: объём рассчитывается так, чтобы открытая задача каждого пользователя объёмом 128–256 тысяч токенов постоянно находилась в памяти GPU, по одной сессии на FTE разработчика.
- Память на сессию: сохраняется с 8-битной точностью, используя один байт на число вместо обычных двух. Эту память хранят только 16 из 64 слоёв модели (её конфигурационный файл): 16 слоёв умножить на 2, на 4 головы внимания, на 256 значений и на 1 байт даёт 32 КБ на токен. Это составляет около 4 ГБ на сессию при 128 тысячах токенов и 8 ГБ при 256 тысячах.
- Модель и программное обеспечение: сама модель занимает около 28 ГБ в 8-битном формате. Мы исходим из того, что 90 % памяти GPU доступно для использования, а 6 ГБ уходит на обслуживающее программное обеспечение согласно нашим допущениям.
- Сессии на GPU в расчёте на задачи объёмом 128 или 256 тысяч токенов: одна видеокарта на 80 ГБ поддерживает 8 или 4 сессии, две видеокарты, разделяющие одну копию модели, — 23 или 11, а одна B200 — 28 или 14. Карта на 24 ГБ вмещает сжатую копию и одну сессию объёмом примерно до 128 тысяч токенов.
- Скорость: эти расчёты не учитывают скорость работы. Когда несколько человек одновременно отправляют длинные задачи, каждый ждёт завершения обработки данных остальных на GPU.
- Аренда: H100 из списка RunPod Secure Cloud от 23 октября 2026 года стоит от $2,89 за час работы GPU для H100 PCIe до $3,99 для H100 SXM при расчёте на 720 часов в месяц, как указано на нашей странице приватной платформы. SXM — версия, которая соединяет две видеокарты достаточно быстро для совместного использования одной копии модели. Аренда карт на 24 ГБ составляет $640–860 в месяц, а диапазон для карт на 80 ГБ под чат-боты и ИИ-агенты составляет $1 290–2 080 от A100 до H100 PCIe по данным с той же страницы. B200 через Lambda обходится в $7,69, а через Together AI в $9,29 за час работы GPU при расчёте на 730 часов. Сервер в вашей юрисдикции тарифицируется по собственным расценкам.
Что не учитывалось:
- сколько людей работают одновременно, так как меньшее число пользователей в моменте требует меньше GPU;
- скорость обработки при нескольких длинных задачах одновременно;
- влияние 8-битной точности памяти на качество ответов;
- купленное, зарезервированное или иное железо;
- затраты на кэш при реальном использовании;
- результаты моделей, запускаемых самостоятельно на вашем собственном оборудовании;
- стоимость подписок на Qwen;
- количество токенов на задачу ИИ-агента;
- рабочее время ваших сотрудников;
- означает ли максимальный уровень рассуждений (настройка max) одно и то же у разных поставщиков.
Qwen3.8-27B на собственных GPU против тарифов Claude для команд разных размеров
Все три сценария ниже учитывают только аренду видеокарт из расчёта, что рабочие материалы каждого сотрудника объёмом от 128 до 256 тысяч токенов постоянно хранятся в памяти GPU.
- Один сотрудник: одна видеокарта H100 ($2 081–2 873 в месяц) обходится дороже любого облачного варианта из таблицы расходов на разработку. Карта на 24 ГБ ($640–860) вмещает сжатую копию модели и одну задачу объёмом до 128 тысяч токенов, но всё равно стоит дороже подписки на Claude.
- Команда из 10 человек: две видеокарты H100 ($4 162–5 746) дороже подписки Claude Team ($250–1 250) и Qwen3.8-Max в облаке Alibaba ($437–2 026).
- Около 200 человек: 6–11 видеокарт B200 стоимостью $33 682–74 599 обычно обходятся дороже, чем Claude Enterprise для того же числа сотрудников стоимостью $26 125–40 875, включая подписки и использование по средним меркам Anthropic.
- Если работает меньше людей: реальная нагрузка может требовать меньше GPU, чем заложено в наших расчётах. Revolut (выступление их представителей цитируется ниже) обслуживает примерно 36 инженеров на одну видеокарту B200, но использует GLM-5.3 — гораздо более крупную модель с другой архитектурой памяти. Обратная сторона заключается в том, что задача, вытесненная из памяти GPU, при следующем шаге пользователя обрабатывается заново в полном объёме, а ответы замедляются. Нагрузочное тестирование позволяет точно определить необходимое число.
Плюсы и минусы: Claude, Qwen3.8-Max и Qwen3.8-27B для программирования
| Вариант | Плюсы | Минусы |
|---|---|---|
| Claude Opus и Sonnet | Самые высокие баллы среди сравниваемых здесь моделей; Opus выбирают для планирования и разработки требований, а Sonnet используют для написания большей части кода. | Счёт растёт вместе с активностью. На этом тесте Sonnet обходится дороже, чем Opus. |
| Подписка на Claude | Предсказуемые расходы до достижения лимита использования. | Действуют лимиты. Подробнее в материале Тарифы Claude Code для бизнеса. |
| Qwen3.8-Max через облако Alibaba | Дешевле Claude Sonnet за один тестовый запуск. Стоимость составляет от трети затрат на Opus до примерно той же суммы. | Самый низкий результат на Terminal-Bench 4.1 среди участников: около 27 задач из 100 против 64–66 у лучших моделей Claude. Код уходит в облако Alibaba. Цена подписки на Qwen Code не была опубликована там, где мы могли её прочитать. |
| Qwen3.8-27B на собственных GPU | Код остаётся внутри контура, и отсутствует плата за токены. | Аренда GPU превышает тариф Claude для одного человека и команды из 10 человек, а при штате около 200 человек обычно превосходит его при условии удержания каждой задачи в памяти. Модель не имеет баллов на тесте, её скорость не проверена, а затраты на персонал, настройку и развёртывание идут дополнительно. |
Другие размещённые в облаке модели набирают более высокие баллы, чем Qwen3.8-Max, при существенно меньших затратах. DeepSeek V4.1 Flash показывает 38,48 балла при стоимости тестов $185, а GLM-5.3-Flash показывает 36,97 балла при стоимости $375 против $4 636 у Qwen3.8-Max по счетам самого теста.
Для команд разработки, чей код не должен покидать контур компании или страну, наша услуга вайбкодинга предлагает закрытую настройку: на вашем собственном сервере или на мощностях в нужной юрисдикции. Мы настраиваем систему и сопровождаем её.
Цифры одной компании: Revolut
В октябрьском выступлении 2026 года представители Revolut сообщили, что предоставляют открытую модель GLM-5.3 примерно 2 000 инженерам на 56 GPU B200, используя Claude Code и Codex только как исключение. По их оценке, расходы составили «десятую часть от того, что мы тратили на Anthropic и OpenAI». По базовым тарифам аренды 56 GPU обходятся примерно в $157–190 в месяц на одного инженера.
Это ниже наших расчётов, в которых задача каждого пользователя одновременно держится в памяти GPU. В выступлении не указано, сколько инженеров работают параллельно. Там также нет информации о предыдущих тратах и о том, принадлежат ли компании эти GPU, поэтому проверить заявление о «десятой части» невозможно. Предупреждение с сайта доклада гласит: «Эти цифры описывают инфраструктуру и загрузку Revolut, а не универсальную цену для любой модели на своих серверах».
В рублях: Qwen3.8-27B на GPU в российском дата-центре и Qwen3.8-Max через Cloud.ru
Для программирования расчёт для Qwen3.8-27B на собственных GPU устроен так же, как и в таблице в долларах: задача каждого пользователя на 128–256 тысяч токенов держится в памяти GPU целиком, одна сессия на FTE разработчика. Аренда приведена по прайс-листам российских облаков GPU на 21 ноября 2026 года, итоги — это наш расчёт, а колонка Claude содержит долларовые тарифы Claude в пересчёте по курсу ЦБ (Claude не продаёт услуги за рубли). Деньги за аренду идут поставщику облака GPU, а не в Ксентру. Чип B200 не попал в изученные нами прайс-листы (Selectel предлагает B300 только в составе сервера из 8 GPU от 9 000 000 ₽ в месяц), поэтому в примере на 200 человек мы используем H200 (141 ГБ): один H200 поддерживает 20 сессий по 128 тысяч токенов или 10 по 256 тысяч, то есть на 148 сессий нужно от 8 до 15 таких чипов.
| Масштаб | Qwen3.8-27B: GPU | Аренда GPU в месяц | На FTE разработчика | Qwen3.8-Max через Cloud.ru в месяц (с НДС) | Тариф Claude в пересчёте по курсу ЦБ |
|---|---|---|---|---|---|
| Один человек | один H100 | 246 100–614 900 ₽ | 246 100–614 900 ₽ | 9 400–15 700 ₽ | 1 600–16 400 ₽ ($20–200) |
| Команда из 10 человек | два H100 | 504 000–1 229 800 ₽ | 61 100–149 100 ₽ | 77 900–129 800 ₽ | 20 500–102 700 ₽ ($250–1 250); 2 500–12 500 ₽ на FTE разработчика |
| Около 200 человек | 8–15 H200 | 2 436 700–6 237 000 ₽ | 16 500–42 300 ₽ | 1 392 200–2 320 300 ₽ | 2 147 200–3 359 600 ₽ ($26 125–40 875); 14 600–22 800 ₽ на FTE разработчика |
Аренда: чипы H100 — от immers.cloud (246 074 ₽ в месяц за один GPU, 503 978 ₽ за сервер с двумя GPU из прайс-листа; на странице не указан НДС и не уточняется, PCIe это или SXM, что важно при 256 тысячах токенов, когда две видеокарты делят одну копию модели) до управляемого сервиса инференса Cloud.ru на H100 NVLink (854 ₽ в час за GPU с учётом НДС 22 %, 720 часов; это услуга, а не чистый сервер). Чипы H200 — от immers.cloud (304 589 ₽ в месяц) до выделенного сервера Selectel с одной платой H200 NVL (от 415 800 ₽ в месяц; на странице видеокарт НДС не указан). Для одного человека карта на 24 ГБ (RTX 4090) в immers.cloud обойдётся в 59 587 ₽ в месяц и удержит сжатую копию модели вместе с одной задачей объёмом примерно до 128 тысяч токенов. Цены Claude пересчитаны из долларов без учёта налога по курсу ЦБ на 21 ноября 2026 года (82,19 ₽); Claude не продаёт подписки за рубли.
Qwen3.8-Max в рублях. В прайс-листе Cloud.ru (от 21 ноября 2026 года) модель Qwen 3.8 Max продаётся как «партнёрская модель» по цене 355,98 ₽ за миллион входных токенов, 1 067,95 ₽ за миллион выходных токенов и 44,51 ₽ за миллион токенов в кэше с учётом НДС 22 %. По нашим расчётам на основе этих цен один полный прогон теста по программированию на токенах самого теста обходится примерно в 270 500 ₽ с НДС. Без НДС это около 221 700 ₽, что в 1,78 раза дороже стоимости тех же токенов по долларовому прайс-листу Alibaba в пересчёте по курсу ЦБ (около 124 900 ₽ без НДС). Для колонки с месячными затратами мы берём средние траты в Anthropic на уровне $150–250 на разработчика и пересчитываем их с учётом соотношения стоимости этого прогона в Cloud.ru к стоимости прогона Opus 5.5 по прайс-листу Anthropic (0,63, обе цифры без НДС), после чего добавляем НДС. В долларовой таблице также используются данные по счетам самого теста, которых у Cloud.ru нет, а запись в кэш не учитывается, поэтому эти суммы отражают нижнюю границу затрат. Показатель примерно в 27 решённых задач из 100 относится к модели, которую развёртывает у себя Alibaba. В прайс-листе Cloud.ru собственные модели и «партнёрские» разнесены по разным разделам, а в описании услуг (по состоянию на 24 октября 2026 года) указано, что запросы к внешним моделям уходят через интернет на серверы соответствующих поставщиков.
Насколько хорош Qwen на русском?
Чат-бот или ИИ-агент для российской компании работает на русском языке, поэтому теста по программированию выше недостаточно. MERA — общий тест для проверки моделей на русском языке, который оценивает задачи на знания и рассуждение по шкале от 0 до 1, чем выше, тем лучше. Он не проверяет ответы по документам вашей компании; для этого проводят пилотный проект по разделу как выбрать. Независимых тестов на повседневную офисную работу на русском языке мы не нашли.
| Модель | Балл MERA по тексту (по состоянию на 19 ноября 2026 года) | Примечание |
|---|---|---|
| Claude Opus 5 | 0,631 | модель за июль; в MERA нет строки для Opus 5.5 |
| DeepSeek V4.1 Flash | 0,581 | |
| Qwen3.5-397B-A17B | 0,485 | лучшая строка Qwen; требует несколько GPU |
| Qwen3.6-27B | 0,435 | один GPU |
| Qwen3.6-35B-A3B | 0,391 | один GPU; модель, которую продают MWS и Cloud.ru |
| Qwen3.8-27B | 0,394 | один GPU; продаётся в Selectel и как партнёрская модель в Cloud.ru |
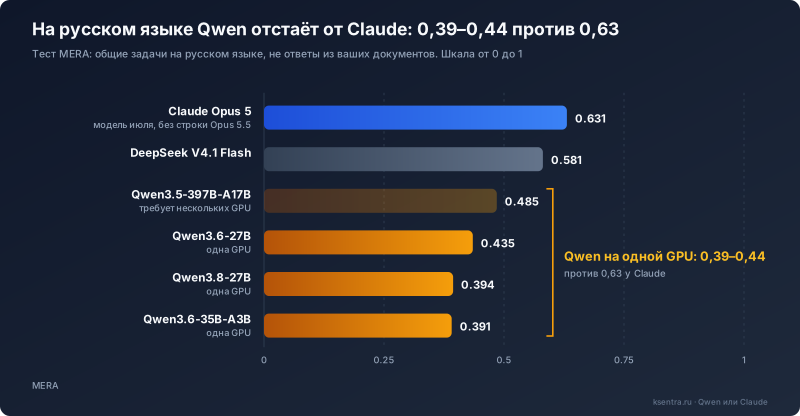
Модели Qwen, которые вы можете запустить на одном GPU или купить у российских облаков из этой статьи, набирают 0,39–0,44 (там, где у модели есть строка в MERA). У Claude Opus 5 результат составляет 0,63. Лучшая строка Qwen, 0,485, принадлежит модели Qwen3.5-397B-A17B, которой требуется несколько GPU; Cloud.ru продаёт к ней доступ на собственной инфраструктуре по более высокой цене (рублёвый маршрут). У Qwen3.8-Max, Qwen4-Max и Qwen3.8-Flash-Next нет строчки в MERA. В этом тесте более ранняя модель Qwen3.6-27B набрала больше баллов, чем более новая Qwen3.8-27B, а таблица лидеров не раскрывает детали запуска вроде режима рассуждений, поэтому проверяйте результаты для конкретной версии модели. Сжатие тоже снижает показатели: 4-битная сборка Qwen3.6-35B-A3B набрала 0,387 против 0,391.
Чат-боты и ИИ-агенты: сколько стоят Qwen или Claude либо работа на собственных серверах
Токены чат-бота обходятся недорого на любой компактной модели. Зато токены агента на мощной модели могут стоить как аренда видеокарты, а при долгих задачах и дороже.
Чат-боты
Мы используем гибридные чат-боты: стандартные сценарии отрабатывает скрипт, а на открытые вопросы отвечает модель. По данным 83 диалогов в наших собственных чат-ботах с июля по октябрь 2026 года, типичный диалог расходует около 2 200 токенов, а средний около 4 000, поэтому в расчётах ниже мы используем среднее значение. Объёмы в таблице показывают примерную нагрузку для клиентских и внутренних чат-ботов компании, а столбец «на 1 000 чатов» поможет пересчитать бюджет под ваши показатели.
| Модель, только стоимость токенов (наши расчёты по прайс-листам) | На 1 000 чатов | Один сотрудник: 1 000 чатов в месяц | Команда из 10 человек: 10 000 чатов | Около 200 сотрудников: 100 000 чатов |
|---|---|---|---|---|
| Claude Haiku 5.5 | $0,49 | $0,49 | $4,90 | $49 |
| Claude Sonnet 5.5 | $9,81 | $9,81 | $98 | $981 |
| Qwen3.8-Flash через облако Alibaba | $0,67 | $0,67 | $6,71 | $67 |
| Qwen4-Max через облако Alibaba | $6,66 | $6,66 | $67 | $666 |
| Собственные серверы, аренда GPU в облаке | — | $640–860 (один GPU на 24 ГБ) | $640–2 080 (от одного GPU на 24 ГБ до одного A100 или H100 PCIe на 80 ГБ) | $1 290–2 080 за один GPU на 80 ГБ (A100 или H100 PCIe, точное количество покажет тест при вашей реальной нагрузке) |
ИИ-агенты
ИИ-агент решает задачу в несколько шагов и читает значительно больше текста, чем в обычном чате. Для агента, который отвечает по вашим документам, мы закладываем 50 000 токенов на задачу. Кодинг-агенты обрабатывают ещё больше текста. Часть текста в каждой задаче кэшируется, то есть уже прочитана системой и оплачивается по сниженному тарифу. Стоимость одной задачи приведена для того, чтобы вы могли пересчитать бюджет под свои объёмы.
| Модель, только стоимость токенов (наши расчёты по прайс-листам) | На одну задачу (без кэша) | Команда из 10 человек: 1 050 задач в месяц | Около 200 сотрудников: 21 000 задач |
|---|---|---|---|
| Claude Haiku 5.5 | $0,0062 | $2,96–6,51 | $59–130 |
| Claude Sonnet 5.5 | $0,124 | $55–130 | $1 104–2 604 |
| Qwen3.8-Flash через облако Alibaba | $0,0085 | $3,59–8,88 | $72–178 |
| Qwen4-Max через облако Alibaba | $0,084 | $32–88 | $639–1 764 |
| Собственные серверы, аренда GPU в облаке | — | $640–860 (один GPU на 24 ГБ) | $1 290–2 080 за один GPU на 80 ГБ (A100 или H100 PCIe) |
Для одного сотрудника задачи агента не рассчитывались.
Что показывают таблицы
- Чат-боты: даже при нагрузке в 100 000 чатов в месяц (примерно по 4 000 токенов на каждый) токены для небольшой модели обойдутся в $49–67, а для более крупной в $666–981 (учитываются только токены). Запуск на собственных серверах начинается с аренды одного GPU на 24 ГБ стоимостью $640–860 в месяц независимо от нагрузки. Поэтому самостоятельный запуск модели для чат-бота означает выбор в пользу контроля над данными.
- ИИ-агенты, пример на 200 сотрудников (21 000 задач в месяц, по 50 000 токенов на задачу, кэширование от 0 до 80 %, наши допущения): аренда одного GPU на 80 ГБ (A100 или H100 PCIe) стоит $1 290–2 080. Токены для агента на базе Sonnet 5.5 обойдутся примерно в ту же сумму ($1 104–2 604), а для Qwen4-Max почти столько же ($639–1 764). Варианты с Haiku 5.5 и Qwen3.8-Flash стоят значительно дешевле ($59–130 и $72–178 соответственно). Какое сравнение честное, зависит от качества ответов по вашим документам.
| Вариант | Чем хорош | На что обратить внимание |
|---|---|---|
| Облачная модель (Claude или Qwen через облако Alibaba) | нет затрат на железо; минимальные расходы на токены компактных моделей | ваши документы уходят поставщику модели; использование мощных моделей для агентов заметно увеличивает бюджет |
| Открытая модель через API стороннего провайдера (оплата по факту использования) | низкая стоимость токенов | путь не приватный: документы отправляются в облако провайдера на условиях его оферты |
| Открытая модель на собственных серверах | документы остаются под вашим контролем; нет платы за токены | аренда от $640 в месяц при любой нагрузке; расходы на администрирование и настройку; модели, помещающиеся на одном сервере, могут отвечать хуже |
Ни одно независимое тестирование, с которым мы знакомы, не оценивает качество ответов по внутренним документам компании. Наша облачная платформа и частная платформа проверяют модели на ваших вопросах ещё до выбора конкретного решения, после чего мы запускаем пилотный проект. Наши боты и ИИ-агенты отвечают на входящие обращения пользователей. Мы не занимаемся исходящими звонками и голосовыми ИИ-агентами.
Как мы считали: учитывались только затраты на токены без учёта рассуждений модели (reasoning); расходы на настройку, хостинг базы знаний и наши услуги не включены. Задачи агентов: по 50 000 токенов каждая, от 0 до 80 % текста кэшируется по тарифам поставщиков, запись в кэш не тарифицировалась, в расчётах для команд заложено около 105 задач на сотрудника в месяц.
Qwen API в рублях в российском облаке
Российские облачные провайдеры продают доступ к Qwen API за рубли, с оплатой за токены. Цены ниже приводятся по прайс-листам провайдеров за 1 миллион токенов на 21 ноября 2026 года, с учётом НДС, как указывает провайдер.
| Провайдер | Модель Qwen | Рублей за 1 млн токенов (вход / выход / кэш) | Условия по НДС |
|---|---|---|---|
| Selectel Token Factory | Qwen-3.8-27B | 31,01 / 206,5 (3,1) | не указано |
| Selectel Token Factory | Qwen-3.8-Flash-Next | 20,85 / 61,3 (2,09) | не указано |
| MWS GPT | qwen3.6-35b-a3b | 70,76 / 283,04 (без кэша) | с НДС 22% |
| Cloud.ru, собственные модели | Qwen3.6-35B-A3B | 219,60 / 329,40 (без кэша) | включая НДС 22 % |
| Cloud.ru, собственные модели | Qwen3.5-397B-A17B (лучшая модель строки Qwen на MERA, 0,485) | 915 / 1 085,80 (без кэша) | включая НДС 22 % |
| Cloud.ru, партнёрская модель | Qwen 3.8 27B | 89,00 / 533,98 (17,80) | включая НДС 22 % |
| Cloud.ru, партнёрская модель | Qwen 3.8 Max | 355,98 / 1 067,95 (44,51) | включая НДС 22 % |
По поводу обработки данных Selectel заявляет: «Запросы обрабатываются на инфраструктуре Selectel в России. Данные не покидают периметр страны и не передаются зарубежным провайдерам моделей», а о хранении: «Мы не храним ваши промпты и ответы моделей, не логируем запросы и не используем ваши данные для дообучения нейросетей». Для партнёрских моделей Cloud.ru в описании услуг указано, что запросы к внешним моделям уходят через интернет на серверы соответствующих поставщиков.
Во сколько обходятся чат-боты и агенты. Наши расчёты базируются на публичных прайсах провайдеров от 21 ноября 2026 года. Учитываются только токены без затрат на настройку, хостинг и наши услуги, режим рассуждений отключён. Объёмы нагрузки взяты из таблиц для чат-ботов и агентов выше: в среднем около 4 000 токенов на один диалог для ботов и 50 000 токенов на задачу для агентов.
| Провайдер и модель | 1 000 чатов | Команда из 10 человек: 10 000 чатов | Около 200 сотрудников: 100 000 чатов | Задача агента без кэша | Около 200 сотрудников: 21 000 задач агента |
|---|---|---|---|---|---|
| Selectel, Qwen-3.8-Flash-Next (база НДС не указана) | 92 ₽ | 923 ₽ | 9 200 ₽ | 1,16 ₽ | 9 600–24 400 ₽ |
| Selectel, Qwen-3.8-27B (база НДС не указана) | 164 ₽ | 1 600 ₽ | 16 400 ₽ | 2,08 ₽ | 21 600–43 600 ₽ |
| MWS, qwen3.6-35b-a3b (с НДС) | 331 ₽ | 3 300 ₽ | 33 100 ₽ | 4,17 ₽ | 87 700 ₽ |
| Партнёрская модель Cloud.ru, Qwen 3.8 27B (с НДС) | 457 ₽ | 4 600 ₽ | 45 700 ₽ | 5,78 ₽ | 65 300–121 500 ₽ |
| Собственная модель Cloud.ru, Qwen3.6-35B-A3B (с НДС) | 899 ₽ | 9 000 ₽ | 89 900 ₽ | 11 ₽ | 237 500 ₽ |
Расчёты выполнены на основе прайсов от 21 ноября 2026 года; все три модели отличаются. Диапазон для агентов учитывает кэширование от 0 до 80 % текста по тарифам провайдеров, если кэш поддерживается. Если цены кэша нет, каждый токен считается входящим. Для сравнения: Claude Haiku 5.5 стоит $0,49 за 1 000 чатов, а Qwen3.8-Flash в облаке Alibaba — $0,67 без учёта налогов. Это примерно 40 и 55 рублей по курсу ЦБ, а не реальные цены в рублях.
Модели Qwen 3.8 рассуждают по умолчанию, и в карточке модели указано, что рассуждения из предыдущих сообщений могут сохраняться в диалоге. Всё это добавляет токены. Мы не знаем точно, как именно каждый провайдер тарифицирует и передаёт эти служебные токены, поэтому суммы для чатов и агентов в этом разделе стоит воспринимать как минимальный ориентир. Реальные расходы покажет пилотный проект. У MWS также действует ночной тариф на модель qwen3.6-35b-a3b: с 01:00 до 07:00 по московскому времени стоимость составляет 50,02 / 197,64 ₽ за миллион токенов против дневных 70,76 / 283,04 ₽ с учётом НДС.
Компромисс в цифрах. В Selectel более сильная модель стоит дороже. DeepSeek-V4.1-Flash-1017 обойдётся в 243,2 / 486,4 ₽ за миллион токенов против 31,01 / 206,5 ₽ у Qwen-3.8-27B по прайсам на 21 ноября 2026 года (база НДС в Selectel не указана). Это примерно в 7,8 раза дороже по входу и в 2,4 раза по выходу. При этом версия DeepSeek V4.1 Flash набирает 0,581 на тесте MERA против 0,394 у Qwen3.8-27B, а в тестах на написание кода показывает 38,48 балла против 26,97 у Qwen3.8-Max. У моделей Qwen от Selectel результатов по коду нет. Поэтому Qwen — один из вариантов. Сравните две-три модели на своих задачах, прежде чем делать выбор. Российские провайдеры и инструменты для разработки разобраны в нашем гиде по альтернативам Claude Code. Наша платформа в российском облаке запускает такое сравнение для двух или трёх моделей на 20–30 ваших собственных вопросах, чтобы помочь выбрать оптимальный вариант.
Нужна платформа для ботов и агентов, подходящая под ваши данные?
Расскажите, что у вас уже работает или планируется, и мы покажем, какой вариант подходит под ваши данные и сколько он стоит в месяц.
Что даёт запуск модели своими силами и во сколько это обходится помимо GPU
Локальная LLM — языковая модель на сервере под вашим контролем — даёт три преимущества:
- код и документы не передаются сторонним ИИ-сервисам;
- служба безопасности может проверить систему на соответствие внутренним регламентам;
- отсутствует плата за каждый токен.
Это требует затрат, которые выходят далеко за рамки покупки видеокарт:
- Оборудование или аренда. Одна видеокарта на 80 ГБ поддерживает модель Qwen3.8-27B и память GPU для параллельной работы примерно восьми пользователей над длинными задачами по коду (по 128 тысяч токенов каждая) либо четырёх пользователей при объёме по 256 тысяч токенов. Скорость ответа при нагрузке в восемь человек показывают только нагрузочные тесты. Карта на 24 ГБ вмещает сжатую копию модели и одну задачу объёмом до 128 тысяч токенов. Какая модель подходит под конкретный сервер и сколько это стоит за месяц, мы указываем на нашей странице приватной платформы. Один сервер не гарантирует отказоустойчивость, а второй сервер для бесперебойной работы удваивает арендную плату.
- Персонал и настройка. Кто-то должен обслуживать серверы, обновлять модели и следить за скоростью. Настройка в Revolut сократила ожидание первого слова ответа с 14 секунд до менее чем двух.
- Качество. Открытые модели, которые помещаются на одном или двух серверах, могут отвечать менее точно, чем самые мощные облачные решения. Для моделей Qwen, работающих на одном сервере, нет результатов тестов по написанию кода. Компания Alibaba провела три публичных теста по коду самостоятельно и опубликовала их на страницах моделей Qwen3.8-27B и весов Qwen3.8-Max. В них модель Qwen3.8-27B набирает 75–91 % от показателей Qwen3.8-Max: 91 % в SWE-bench Pro, 76 % в NL2Repo и 75 % в DeepSWE. На независимом тесте Qwen3.8-Max успешно справляется примерно с 27 задачами из 100, тогда как лучшие модели Claude решают 64–66 задач. Собственные тесты Alibaba не являются независимыми.
- Наши услуги. На странице приватной платформы расчёт инфраструктуры стоит 30 000 ₽ и входит в стоимость развёртывания приватной платформы на серверах под вашим контролем (цена от 300 000 ₽). Удалённая поддержка стоит от 25 000 ₽ в месяц.
Где запускаются открытые модели
| Сервер | Модели | Лицензия | Примечание |
|---|---|---|---|
| Один GPU | Qwen3.8-27B (из таблицы на нашей странице приватной платформы), Qwen3.6-27B (предыдущая версия) | Apache-2.0 | результатов тестов по коду нет; на публичных тестах самой Alibaba Qwen3.8-27B набирает 75–91 % от Qwen3.8-Max; выбор между моделями делается по результатам пилотного проекта на ваших задачах |
| Более мощный сервер | Qwen3.8-Flash-Next (в Alibaba её называют предварительной версией архитектуры Qwen4) | собственная лицензия Qwen | нет результатов в тестах на кодинг |
| Кластер серверов | Qwen3.8-2.4T-A95B, открытые веса, на базе которых создана Qwen3.8-Max | собственная лицензия Qwen | хостинговая версия Qwen3.8-Max решает 26,97 задач из 100 на тесте по коду |
| Восемь крупных GPU | GLM-5.3 (Z.ai) | собственная лицензия | 41,21 балла в тесте на кодинг в конфигурации от Z.ai, что выше любого результата Qwen |
Формулировка «один GPU» обычно означает использование сжатой модели. Веса такой модели хранятся с меньшим количеством бит на число, поэтому она занимает меньше памяти, хотя сжатие может немного снизить качество. Модель с 27 миллиардами параметров помещается на карту с 24–32 ГБ памяти в сжатом виде. При этом остаётся запас под одну задачу объёмом до 128 тысяч токенов. На карте с 80 ГБ при 8-битной точности хватит памяти примерно на 8 пользовательских задач по 128 тысяч токенов каждая. Для написания кода открытая модель на ваших серверах не обязательно должна быть создана Qwen.
Лицензии кратко
- Qwen3.8-27B и Qwen3.6-27B распространяются под лицензией Apache-2.0: компания может использовать их в коммерческих целях, но при передаче модели другим лицам обязана включить текст лицензии.
- Qwen3.8-Flash-Next и веса модели Max распространяются по собственным лицензиям Qwen (Flash-Next, веса Max). Отдельная лицензия от Qwen потребуется только в том случае, если ваша компания или любое юридическое лицо из вашей группы продаёт доступ к ИИ-моделям либо продаёт собственного ИИ-ассистента как отдельный продукт для работы с кодом или офисных задач. Для весов Max эта лицензия требуется при выручке группы компаний более $50 млн в год.
- Даже в этом случае использование таких моделей внутри компании без передачи самой модели или её ответов внешним лицам не требует приобретения отдельной лицензии.
- Лицензия GLM-5.3 добавляет проверку безопасности со стороны Z.ai, но только для групп компаний, продающих доступ к ИИ-моделям с общей выручкой более $10 млрд в год. Модель GLM-5.3-Flash распространяется под лицензией MIT.
- При использовании через API провайдера запуск модели обеспечивает сам поставщик, а вы работаете в рамках его договора.
Наша услуга приватной платформы работает с моделями на базе Apache-2.0 и MIT, а при использовании Flash-Next, весов Max или GLM-5.3 лицензию оформляете вы самостоятельно. Для команд разработки наше предложение по вайбкодингу включает такой же вариант: закрытую настройку.
Как выбрать между Qwen и Claude: тест на ваших задачах
- Написание кода, и ваша компания может использовать Claude. Если допускается отправка кода в облако, Claude показывает значительно более высокие результаты, чем Qwen3.8-Max. Посмотрите подходящую под ваш масштаб колонку в таблице стоимости кодинга. Наша услуга по вайбкодингу поможет определить, какой именно код можно отправлять во внешние сервисы, и проведёт пилотный проект.
- Пишете код, но доступ к Claude для вашей компании закрыт (правила Anthropic). Qwen3.8-Max покупается за рубли через Cloud.ru: версия, которую запускает сама Alibaba, решает примерно 27 задач из 100 (его стоимость); другие модели с открытыми весами показывают более высокие результаты на том же тесте (сравнение моделей с открытыми весами); также можно запустить модель с открытыми весами на собственных серверах.
- Код или данные не должны покидать компанию. Модель с открытыми весами на собственных серверах: что это даёт и во сколько обходится.
- Ограниченный бюджет, код можно отправлять в облако и компания может использовать Claude. Сопоставьте Qwen3.8-Max с Sonnet на ваших собственных задачах. Модель от Qwen дешевле в расчёте на один запуск, а тест покажет, какую часть работы она не сможет выполнить. Наша услугаоблачной платформы может провести такое тестирование вместе с вами.
- Российский контракт и расчёты в рублях важнее разницы в качестве, а правила использования модели не запрещают её применение. Чат-боты и ИИ-агенты на базе модели Qwen в российском облаке: рублёвый путь и наша платформа в российском облаке.
- Повседневная переписка, подготовка текста и анализ. Ни один прочитанный нами независимый тест это не покрывает, поэтому тестируйте модели самостоятельно по той же схеме.
Суть теста проста: пропустите 20–30 реальных задач (исправление ошибок, небольшие доработки, ответы клиентам) через два или три кандидата и посчитайте, сколько из них проходит без доработок. Таблица для заполнения:
| Задача | Прошла без доработок? | Минут на исправление |
|---|---|---|
Наша облачная ИИ-платформа и частная ИИ-платформа проверяют работу моделей на ваших вопросах ещё до выбора конкретного решения, после чего запускают пилотный проект (для приватной платформы тестирование сначала проводится на неконфиденциальных или смоделированных документах).
Часто задаваемые вопросы
Qwen vs Claude: что лучше?
Для написания кода Qwen пока уступает. На тесте Terminal-Bench 4.1 при максимальном уровне рассуждений (настройка max) в Claude Code старшие модели Claude справляются примерно с 66 задачами из 100, а Qwen3.8-Max показывает результат лишь в 27 задач. Для интеграции в чат-бот выбор зависит от ваших требований к размещению данных.
Дешевле ли Qwen, чем Claude?
Нет, за исключением масштаба примерно в 200 сотрудников при сопоставлении с тарифным планом Claude, который выбрал бы покупатель. В расчёте на один FTE разработчика в месяц Qwen3.8-Max через облако Alibaba стоит $53–246. Для сравнения: тарифы Claude Pro и Ultra обходятся в $20–200, Claude Team в $30–152, а Claude Enterprise в $177–277. Оценка по Qwen получена нами на основе средних данных от Anthropic и стоимости каждой модели в тесте по коду. Один запуск теста по коду для Qwen стоит дешевле, чем для Claude Sonnet 5.5, и до примерно той же суммы, что у Opus 5.5. При этом Qwen решает гораздо меньше задач: примерно 27 из 100 против 64–66 у лучших моделей Claude.
Выгодно ли разворачивать модель на собственных мощностях?
Нет, если речь идёт об одном сотруднике или команде из 10 человек. При масштабе около 200 сотрудников ответ, как правило, тоже отрицательный (при почасовой аренде GPU по прайсу). Использование Qwen3.8-27B на собственных GPU с учётом того, что задача каждого пользователя объёмом 128–256 тысяч токенов хранится в видеопамяти, обойдётся в $2 081–2 873 в месяц для одного сотрудника, в $4 162–5 746 для команды из 10 человек и в $33 682–74 599 для коллектива из примерно 200 сотрудников. Тарифы Claude для тех же масштабов стоят $20–200, $250–1 250 и $26 125–40 875 соответственно. Затраты на персонал и настройку инфраструктуры в эти суммы не входят. Если одновременно работает меньше людей, может потребоваться меньше GPU. Точное количество покажет нагрузочное тестирование.
Что нужно, чтобы запустить Qwen локально на собственных серверах?
Чтобы запустить Qwen3.8-27B (лицензия Apache-2.0) на одном GPU H100, потребуется $2 081–2 873 в месяц по тарифам у одного американского GPU-облака. Памяти такой карты хватает примерно на 8 одновременных задач по 128 тысяч токенов. Насколько быстро модель отвечает при такой нагрузке, покажет только тестирование. Видеокарта с 24 ГБ памяти (от $640 в месяц) позволит запустить сжатую версию для одного пользователя или для коротких запросов в чат-боте. К этому добавляются расходы на специалистов и настройку.
Что лучше использовать для клиентского чат-бота?
Ориентируйтесь на требования к хранению и обработке данных. На компактных моделях токены стоят недорого: 100 000 диалогов в месяц на Claude Haiku 5.5 или Qwen3.8-Flash обходятся в $49–67. Расчёт выполнен по публичным прайс-листам при 4 000 токенах на диалог, без учёта расходов на настройку, хостинг и платформу.
Можно ли использовать Qwen бесплатно?
Модели Qwen с открытыми весами можно скачать бесплатно. Вы платите только за оборудование для их работы (от $640 в месяц за аренду одной видеокарты на 24 ГБ) либо за услуги облачного провайдера. Инструмент для разработки Qwen Code с ноября больше не предоставляет бесплатный доступ при регистрации. Платные тарифы Claude начинаются от $20 в месяц за подписку Pro. Бесплатные версии веб-чатов обоих сервисов мы не сравнивали.
Уходят ли код и данные при работе с Qwen?
Маршрут данных зависит от площадки. При запуске на собственных серверах код и данные остаются внутри вашей компании. При работе через облако Alibaba данные уходят в Alibaba, и ваши собственные правила работы с данными определяют, допустимо ли это. В российских облаках следует опираться на заявления самих провайдеров. Selectel сообщает, что обрабатывает запросы на собственной инфраструктуре в России и не передаёт данные за рубеж.
Может ли российская компания использовать Claude?
В списке поддерживаемых регионов Anthropic (на 19 ноября 2026 года) Россия не указана. С 12 ноября 2026 года правила также исключают организации, зарегистрированные или имеющие головной офис в неподдерживаемом регионе, а также организации, большей частью принадлежащие или контролируемые из такого региона, в том числе при доступе через облачные платформы и авторизованных реселлеров. Относятся ли эти правила к вашей компании, стоит проверить вместе с юристами. Для компании, подпадающей под эти правила, вариантами на этой странице являются запуск Qwen на собственных серверах или покупка Qwen за рубли в российском облаке.
Сколько стоит Qwen API в рублях?
По публичным тарифам на 21 ноября 2026 года 1 000 средних диалогов (около 4 000 токенов каждый, по статистике наших ботов) обходятся примерно в 92 ₽ для Selectel Qwen-3.8-Flash-Next и 164 ₽ для Qwen-3.8-27B в том же облаке (база НДС не указана). В MWS модель qwen3.6-35b-a3b стоит 331 ₽ с НДС, а на Cloud.ru модель Qwen3.6-35B-A3B обойдётся в 899 ₽ с НДС. В расчёте учтены только токены без токенов рассуждений, при этом сравниваются разные модели. Реальный уровень расходов покажет пилотный проект.
Насколько хорош Qwen на русском языке?
На бенчмарке MERA, оценивающем владение русским языком (данные на 19 ноября 2026 года), модели Qwen для одного GPU или из российских облаков набирают 0,39–0,44 балла. Для сравнения, у Claude Opus 5 этот показатель составляет 0,63. Максимальный результат Qwen (0,485) требует работы на нескольких GPU. Этот тест не отражает качество работы с вашими внутренними документами, его покажет только пилотный проект на ваших реальных задачах.
Можно ли использовать Qwen в коммерческих целях?
Да, с учётом лицензии конкретной модели. Qwen3.8-27B и Qwen3.6-27B распространяются по лицензии Apache-2.0: при передаче модели необходимо сохранить текст лицензии. Для Qwen3.8-Flash-Next и весов версии Max отдельная лицензия от разработчиков Qwen потребуется только в том случае, если ваша группа компаний продаёт собственного ИИ-ассистента для написания кода или работы с документами, либо продаёт доступ к ИИ-моделям (для версии Max — при выручке группы свыше $50 млн в год).
Не уверены, какой вариант подходит под ваши задачи и масштаб?
Начните с бесплатной 30-минутной консультации: расскажите, что должна делать модель и какие правила действуют для вашего кода и данных. Мы подскажем, где развернуть систему и какие варианты протестировать на ваших задачах.
Что изменилось с первой публикации этой страницы
| Дата | Изменение | Что это значит для вас |
|---|---|---|
| Ноябрь | Страница входа Qwen Code теперь запрашивает платную подписку Qwen, ключ API или собственную модель; бесплатный тариф закрыт | не планируйте запуск Qwen Code бесплатно |
| 17 ноября | Новый лидер в Terminal-Bench 4.1: GitHub Copilot с Copilot Fusion, 71,21 | разрыв здесь измеряется по лучшим моделям Claude, а не по верхушке общего рейтинга |
| 16 ноября | Qwen4-Max: только в облаке Alibaba, без открытых весов и результатов в Terminal-Bench. Alibaba заявляет шестое место на Code Arena (сторонний рейтинг со слов компании) и обещает выпустить меньшие модели Qwen4 с открытыми весами «в ближайшее время» | ничего нового для запуска на собственных серверах пока не появилось |
| 13 ноября | Ночной тариф MWS для qwen3.6-35b-a3b: 50,02 / 197,64 ₽ за миллион токенов на вход и выход против 70,76 / 283,04 ₽ днём, с 01:00 до 07:00 по московскому времени с НДС | MWS заявляет скидку до 30 % от базовой цены в эти часы; прайс-лист Cloud.ru тоже содержит ночные тарифы, которые здесь не сравниваются |
| 12 ноября | Вступает в силу политика Anthropic в отношении поддерживаемых регионов: она исключает компании, зарегистрированные или имеющие штаб-квартиру в неподдерживаемом регионе, а также большей частью принадлежащие или контролируемые из такого региона, в том числе через облачные платформы и авторизованных реселлеров | для подпадающей под эти ограничения компании Claude недоступен; эта статья оценивает стоимость Qwen на собственных серверах и в российских облаках в рублях |
| 9 ноября | Claude Code с Fable 5.2 показывает результат 65,76 наравне с Opus 5.5, при этом счёт за тестовый прогон примерно в 3,5 раза выше, чем у Opus 5.5 | лучший результат Claude в тесте не изменился |
Мы вернёмся к этой странице, когда появятся открытые веса Qwen4 или результаты Qwen4 в тесте.