ИИ в закрытом контуре
Открытая языковая модель на серверах под вашим контролем: запросы обрабатываются внутри периметра, а модель подбирается по тестам на ваших реальных вопросах.
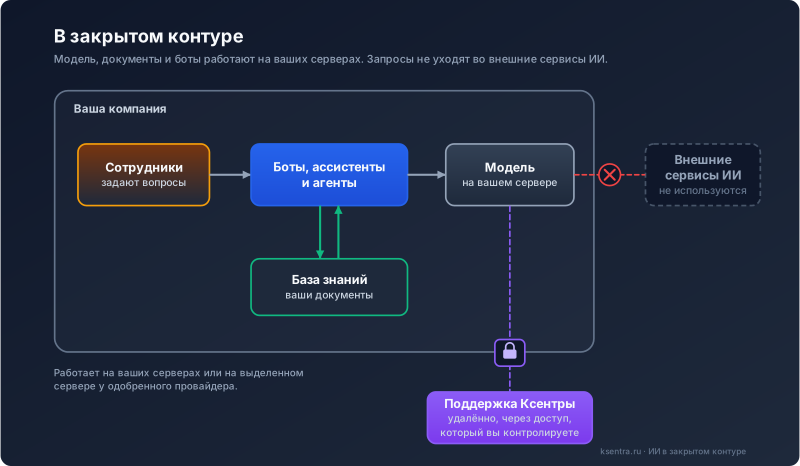
ИИ в закрытом контуре — это языковая модель на серверах под вашим контролем, рядом с базой знаний и ботами. Запросы обрабатываются прямо там и не уходят во внешние сервисы ИИ. Служба безопасности может проверить всё решение по внутренним регламентам компании.
За изоляцию данных приходится платить оборудованием и отчасти качеством ответов. Открытые модели, которые помещаются на один или два сервера, уступают передовым облачным моделям. Поэтому сначала идёт пилот: он показывает, как открытые модели отвечают на ваши реальные вопросы, до того как вы купите оборудование и внесёте второй платёж за настройку.
Нужен ли вам закрытый контур вообще, мы подробно разбираем на странице ИИ-платформа. Эта страница для случаев, когда данные нельзя передавать во внешние сервисы ИИ. Ниже рассказываем, где разместить модель, какие открытые модели подойдут, какое оборудование потребуется и сколько всё это стоит в месяц.
Четыре варианта размещения модели
Модель можно развернуть на собственных серверах, на выделенном сервере у хостинг-провайдера, одобренного службой безопасности, на арендованном сервере с GPU в российском дата-центре или использовать облачную модель в России.
| Собственные серверы (в офисе или в собственной стойке) | Выделенный сервер у одобренного провайдера | Аренда GPU-сервера в российском дата-центре | Облачная модель в России | |
|---|---|---|---|---|
| Где хранятся данные | на ваших серверах: внутри вашего контура | на выделенном сервере провайдера: по вашему договору | на арендованном сервере в дата-центре: по вашему договору | в облаке поставщика |
| Оборудование | покупаете сами или через наших партнёров; конфигурацию рассчитываем мы | сервер хостинг-провайдера | помесячная аренда у наших партнёров | без своего оборудования |
| Срок получения сервера | самый долгий из-за закупки оборудования | недели | дни | дни |
| Что вы оплачиваете | покупка оборудования, электроэнергия и аренда места в стойке дата-центра | ежемесячная аренда | ежемесячная аренда (см. таблицу оборудования ниже) | оплата за токены |
| Кому подходит | компаниям со строгим запретом на выход данных за периметр | если служба безопасности одобряет работу с хостингом по договору | для пилота на тестовых документах или для эксплуатации, если правила позволяют | если данные могут покидать периметр компании, но должны оставаться в России: см. облачная ИИ-модель |
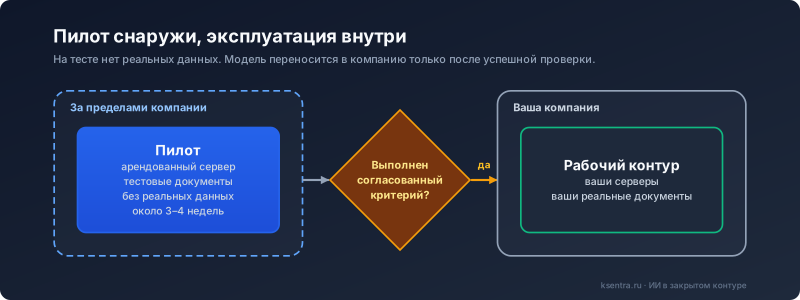
Только первый вариант оставляет данные на вашем собственном оборудовании внутри корпоративного периметра (в серверной офиса или в своей стойке в ЦОД). Во втором и третьем случаях данные находятся у хостинг-провайдера или дата-центра, с которым у вас договор. Эти подходы удобно совмещать: провести пилот на арендованном сервере с неконфиденциальными документами, а после того как пилот пройден, перенести всё внутрь своего контура.
Сравнение российских и мировых открытых моделей
Модели с открытыми весами (open-weight) разработчик публикует целиком, поэтому их можно запускать на собственном оборудовании. Они работают на графических процессорах (GPU) с собственной памятью. Объём этой видеопамяти и определяет, какая модель поместится. Буква «B» обозначает миллиарды параметров: чем модель крупнее, тем, как правило, лучше она отвечает, но тем больше памяти требует.
Качество работы на русском языке оценивается по бенчмарку MERA 2.0 от Альянса в сфере ИИ (шкала от 0 до 1, чем выше балл, тем лучше). Лицензии и показатели проверены на страницах моделей и на платформе MERA 22–23 октября 2026 года. Объём видеопамяти в колонке справа рассчитан только на саму модель, без запаса на текст запросов и число одновременных пользователей.
| Модель (разработчик) | Лицензия | Размер | Качество на русском (MERA 2.0) | Минимальная видеокарта |
|---|---|---|---|---|
| GigaChat 3.1 Lightning (Сбер) | MIT | 11,5B, смесь экспертов (MoE) | нет в рейтинге MERA 2.0 | одна видеокарта на 24 ГБ |
| YandexGPT 5 Lite (Яндекс) | лицензия Яндекса: от 10 млн исходящих токенов в месяц нужно обратиться в Яндекс | 8B | нет в рейтинге MERA 2.0 | одна видеокарта на 24 ГБ |
| T-lite 2.1 (Т-Банк, на базе Qwen3) | Apache 2.0 | 8B | MERA 2.0: 0,130 | одна видеокарта на 24 ГБ |
| T-pro 2.1 (Т-Банк, на базе Qwen3) | Apache 2.0 | 33B | MERA 2.0: 0,196 | сжатая (4-бит): одна видеокарта на 24–32 ГБ; без сжатия: одна видеокарта на 80 ГБ |
| Gemma 4 31B (Google) | Apache 2.0 | 31B | MERA 2.0: 0,369 | сжатая (4-бит): одна видеокарта на 24–32 ГБ; без сжатия: одна видеокарта на 80 ГБ |
| Qwen3.6-35B-A3B (Alibaba) | Apache 2.0 | 36B, смесь экспертов (MoE) | MERA 2.0: 0,391; в сжатом виде (4-бит): 0,387 | сжатая (4-бит): одна видеокарта на 24–32 ГБ |
| Qwen3.6-27B (Alibaba) | Apache 2.0 | 27B | MERA 2.0: 0,435 | сжатая (4-бит): одна видеокарта на 24–32 ГБ |
| GigaChat 3.5 Reasoning (Сбер) | MIT | 434B, смесь экспертов (MoE) | MERA 2.0: 0,423 (результат передал разработчик) | нужен сервер с несколькими видеокартами для дата-центров; большинству компаний практичнее использовать её через облако в России |
| Для сравнения: сильнейшие закрытые облачные модели | — | — | MERA 2.0: 0,62–0,68 | только в облаке |
Обрабатываемый текст и одновременные пользователи требуют памяти сверх указанной в таблице. Модели со смесью экспертов (MoE) при генерации каждого слова задействуют лишь часть параметров, поэтому работают быстрее обычных моделей того же размера, но в памяти всё равно должна находиться вся модель. Сжатие до 4 бит (квантование) сокращает память под саму модель примерно в четыре раза по сравнению с несжатой версией, а качество обычно немного снижается.
Выводы из таблицы:
- В закрытом контуре вы отчасти жертвуете качеством ответов ради того, чтобы данные не покидали компанию. На бенчмарке MERA 2.0 лучшие открытые модели под одну видеокарту набирают 0,39–0,44 балла, тогда как сильнейшие облачные модели достигают 0,62–0,68. Насколько хорошо открытые модели отвечают именно на ваши вопросы, показывает пилот.
- «Российские» и «мировые открытые» модели не исключают друг друга. Модели Т-Банка — это дообученные версии Qwen3 от Alibaba.
- Если служба безопасности исключает модели по стране происхождения, мы закладываем это требование в расчёт инфраструктуры. В таблице есть модели из России, США и Китая.
- Рейтинги помогают сузить выбор до двух-трёх вариантов, а итоговую модель определяют тесты на 20–30 реальных запросах вашей компании.
Сервер для локальной LLM: какое оборудование нужно и сколько стоит его аренда
Чтобы запустить LLM на своём сервере, сначала определяют, какой модели какая видеокарта нужна. Цены аренды ниже взяты из прайс-листа одного российского провайдера на 21 октября 2026 года, за полный месяц (720 часов); у наших партнёров цены другие.
| Задачи ИИ | Класс модели | Минимальная видеокарта | Аренда |
|---|---|---|---|
| Ответы сотрудникам или клиентам по базе документов | примерно до 10B без сжатия или до 20B со сжатием | 24 ГБ (уровень RTX 4090) | аренда около 60 000 ₽ в месяц |
| Более точные ответы, работа с таблицами, запросы к внутренним системам | 24–36B, сжатие в 4 бита | 24–32 ГБ (уровень RTX 4090 / 5090) | аренда около 60 000–94 000 ₽ в месяц |
| Те же задачи с более лёгким сжатием, длинные документы, больше одновременных пользователей | 27–36B, сжатие до 8 бит | серверная видеокарта на 80 ГБ | аренда около 246 000 ₽ в месяц |
| Крупные открытые модели | класс 400B, сжатие в 8 бит | сервер с четырьмя видеокартами старшего класса для дата-центров | аренда около 1,24 млн ₽ в месяц у одного провайдера на 21 октября 2026 года (самая крупная конфигурация в его прайс-листе) |
Эти цены показывают порядок сумм: точные цифры фиксируются в расчёте инфраструктуры. Если оборудование покупать, вместо ежемесячной аренды будут разовые затраты на него и расходы на электроэнергию и размещение в ЦОД. Мы не продаём оборудование: его могут поставить наши партнёры, а в расчёте инфраструктуры мы указываем точную конфигурацию, по которой поставщики назовут цену, и сравниваем покупку с арендой при вашей нагрузке.
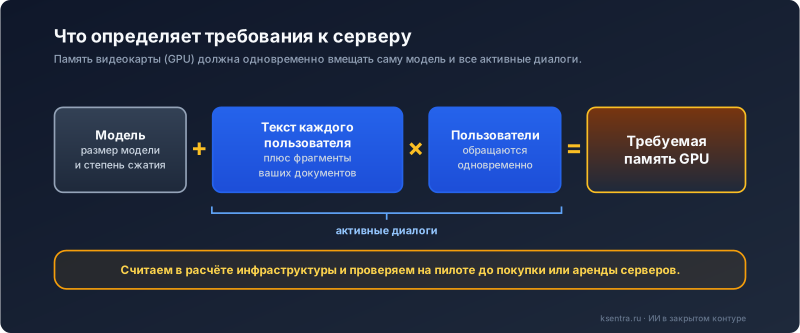
Необходимый объём памяти = сама модель (плюс компактная модель для индексации документов) + (текст запроса каждого пользователя вместе с фрагментами найденных документов × число пользователей, обращающихся одновременно). В таблицах учтена только сама модель. Остальное мы проверяем на пилоте при ожидаемой нагрузке.
Стоимость развертывания LLM в закрытом контуре
Ежемесячные расходы ≈ аренда сервера (или амортизация, электроэнергия и размещение в ЦОД при покупке) × количество серверов + наша поддержка. Счетов за токены здесь нет: сервер обходится в одну и ту же сумму независимо от того, ответил он на сотню вопросов за месяц или на сто тысяч (в пределах своей пиковой мощности). Если мощности перестаёт хватать, добавляется ещё один сервер. Аренду серверов вы оплачиваете напрямую провайдеру или нашим партнёрам: серверы мы не перепродаём.
| Пример: аренда одной видеокарты на 24 ГБ (оценка на 23 октября 2026 года) | Первый месяц | Регулярный месяц, один сервер |
|---|---|---|
| Оплата Ксентре | настройка от 300 000 ₽ + удалённая поддержка от 25 000 ₽ | удалённая поддержка от 25 000 ₽ |
| Оплата сервера (одна видеокарта на 24 ГБ) | около 60 000 ₽ | около 60 000 ₽ в месяц |
| Итого при аренде одной видеокарты на 24 ГБ | около 385 000 ₽ в первый месяц | около 85 000 ₽ в месяц |
При аренде одной серверной видеокарты на 80 ГБ (около 246 000 ₽ в месяц) расходы составят порядка 571 000 ₽ в первый месяц и около 271 000 ₽ в последующие. Для эксплуатации нужны два сервера, это удваивает затраты на серверы: около 120 000 ₽ в месяц за два сервера с видеокартой на 24 ГБ или около 492 000 ₽ за два сервера с видеокартой на 80 ГБ.
Конфигурации на выбор:
- Минимальная (для пилота): один арендованный сервер, неконфиденциальные или синтетические документы (придуманные, но похожие на ваши), ежемесячная проверка.
- Оптимальная (для эксплуатации): два сервера для отказоустойчивости (с серверными видеокартами, если выбрана крупная модель), постоянный мониторинг и обновление моделей. Поддержку этой конфигурации мы оцениваем по итогам расчёта инфраструктуры, она дороже базовой ставки 25 000 ₽ в месяц.
Удалённая поддержка от 25 000 ₽ в месяц — это базовый уровень: ежемесячная проверка, отчёт по расходам и качеству ответов, связь с нами в рабочее время, без гарантии доступности (SLA).
Кто обслуживает систему и как мы получаем доступ к серверам
Формат работы вы выбираете в расчёте инфраструктуры:
- Удалённо (базовый вариант). Мы устанавливаем, обновляем и проверяем платформу через доступ, который выдаёт и контролирует ваша команда.
- Силами вашего администратора. Все операции на серверах выполняет ваш штатный специалист по нашему регламенту (пошаговой инструкции). Мы готовим регламент и проверяем результат. Стоимость поддержки в этом формате согласовывается отдельно.
- С выездом на площадку — по договорённости.
Что вы получаете
- Расчёт инфраструктуры (обязательный этап, 30 000 ₽, засчитывается в стоимость настройки): место размещения модели, два-три кандидата на выбор, подбор видеокарты и прогноз ежемесячных затрат.
- Базу знаний внутри контура, включая компактную модель для индексации документов компании.
- Конфигурацию серверов, подготовленную для наших партнёров, вашего поставщика или хостинга, а затем установленное ПО с подключением к чат-ботам, ассистентам и агентам.
- Критерии успешности пилота, зафиксированные в расчёте до старта тестов. Второй платёж (40% стоимости настройки) вы вносите, только когда пилот выполнит эти критерии.
Что ещё входит в любой проект ИИ-платформы и что остаётся у вас, описано на странице ИИ-платформа.
Что у нас уже работает
Чат-боты на семи действующих сайтах (четыре из них принадлежат сторонним компаниям) запущены на нашем собственном движке (данные на октябрь 2026 года). Он работает с базой знаний и мониторингом и обращается к облачной модели. В закрытом контуре тот же движок будет работать на вашем сервере с открытой моделью, а документы будет индексировать локальная модель. Платный расчёт инфраструктуры и пилот проверяют, подходит ли решение для ваших вопросов, до того как вы оплатите остальную часть проекта.
Частые вопросы
Может ли LLM на своём сервере работать вообще без интернета?
Да, на ваших собственных серверах модель и база знаний работают без подключения к внешним сервисам ИИ. Внутренние ассистенты и агенты могут работать полностью автономно. Боту для общения с клиентами нужен канал связи — сайт или мессенджер, но сами запросы обрабатываются внутри периметра. В полностью изолированной сети платформу обслуживает ваш системный администратор по нашему регламенту, либо наши специалисты работают с выездом на место. Способ доставки обновлений моделей и ПО мы согласовываем с вашей службой безопасности и фиксируем в расчёте инфраструктуры.
Какие модели подходят и как они справляются с русским языком?
В закрытом контуре запускаются как российские разработки (GigaChat 3.1 Lightning, YandexGPT 5 Lite, T-lite и T-pro от Т-Банка), так и открытые мировые модели (Qwen, Gemma). На российском бенчмарке MERA 2.0 лучшие открытые модели под одну видеокарту показывают результат 0,39–0,44 балла против 0,62–0,68 у передовых облачных моделей. Перед выбором мы тестируем двух-трёх кандидатов на 20–30 реальных запросах вашей компании. На пилоте вы видите их ответы рядом и оцениваете качество до второго платежа.
Что выгоднее: покупать оборудование или арендовать?
Аренду можно получить за несколько дней, и она подходит для пилота. Покупка оправдана при длительной стабильной эксплуатации и жёстких регламентах безопасности, но добавляет расходы на электроэнергию и размещение в дата-центре. В расчёте инфраструктуры мы сравниваем оба варианта под вашу нагрузку. Мы не продаём оборудование: вы закупаете его у своих поставщиков или через наших партнёров, а мы готовим конфигурацию и устанавливаем ПО.
Кто обслуживает закрытый контур после запуска?
По умолчанию Ксентра ведёт удалённую поддержку (от 25 000 ₽ в месяц) через контролируемый вами доступ: мы ежемесячно проверяем систему и присылаем отчёт по расходам и качеству ответов. Другой вариант: систему ведёт ваш администратор по нашему регламенту. Выезд на площадку — по договорённости.
Сколько длится пилот и что считается успешным результатом?
Пилот длится около трёх-четырёх недель и проходит на неконфиденциальных или синтетических документах. Критерии успешности мы фиксируем в расчёте инфраструктуры до старта: это качество ответов на вашем тестовом наборе и скорость отклика при ожидаемом числе одновременных пользователей. Второй платёж (40% стоимости настройки) вносится, только когда пилот выполнит эти критерии. Настройка оплачивается тремя платежами: 40% при заключении договора, 40% после успешного пилота и 20% при запуске в эксплуатацию.
Почему для закрытого контура обязателен расчёт инфраструктуры?
Расчёт инфраструктуры обязателен, потому что на его основе закупается или арендуется оборудование. Если выбрать сервер без предварительного тестирования моделей на ваших вопросах, можно переплатить за избыточно мощную видеокарту или получить сервер, которому не хватит памяти. Расчёт стоит 30 000 ₽ и засчитывается в стоимость настройки.
Стоимость
Расчёт инфраструктуры
30 000 ₽
обязателен; засчитывается в стоимость настройки
- Где разместить модель, с альтернативами
- Тестирование 2–3 открытых моделей на ваших вопросах
- Видеокарта и расходы в месяц
- Критерии успешности пилота
Закрытый контур
от 300 000 ₽
настройка · удалённая поддержка от 25 000 ₽ в месяц
- Открытая модель на серверах под вашим контролем
- База знаний внутри периметра компании
- Конфигурация серверов и установка ПО
- Интеграция с ботами, ассистентами, агентами и системами
- Пилот 3–4 недели на неконфиденциальных документах
Ксентре вы оплачиваете расчёт инфраструктуры, настройку и техническую поддержку. За серверы и аренду вы платите напрямую своему поставщику оборудования, хостингу или нашим партнёрам: мы не перепродаём серверы и лицензии. Оплата настройки разбита на этапы: 40% при заключении договора, 40% после успешного пилота и 20% при запуске в эксплуатацию.
Нужен ИИ на серверах под вашим контролем?
Начните с бесплатного 30-минутного созвона. Расскажите, что допускают ваши правила работы с данными и что должен делать ИИ, а мы покажем, какой вариант размещения подойдёт и сколько он стоит в месяц.